Il giovane ricercatore calabrese lavora tra intelligenza artificiale e urologia di precisione: dalla “biopsia virtuale” alle insidie degli algoritmi, fino alla sfida di creare un polo d’eccellenza nella nostra regione
Tutti gli articoli di Attualità
PHOTO
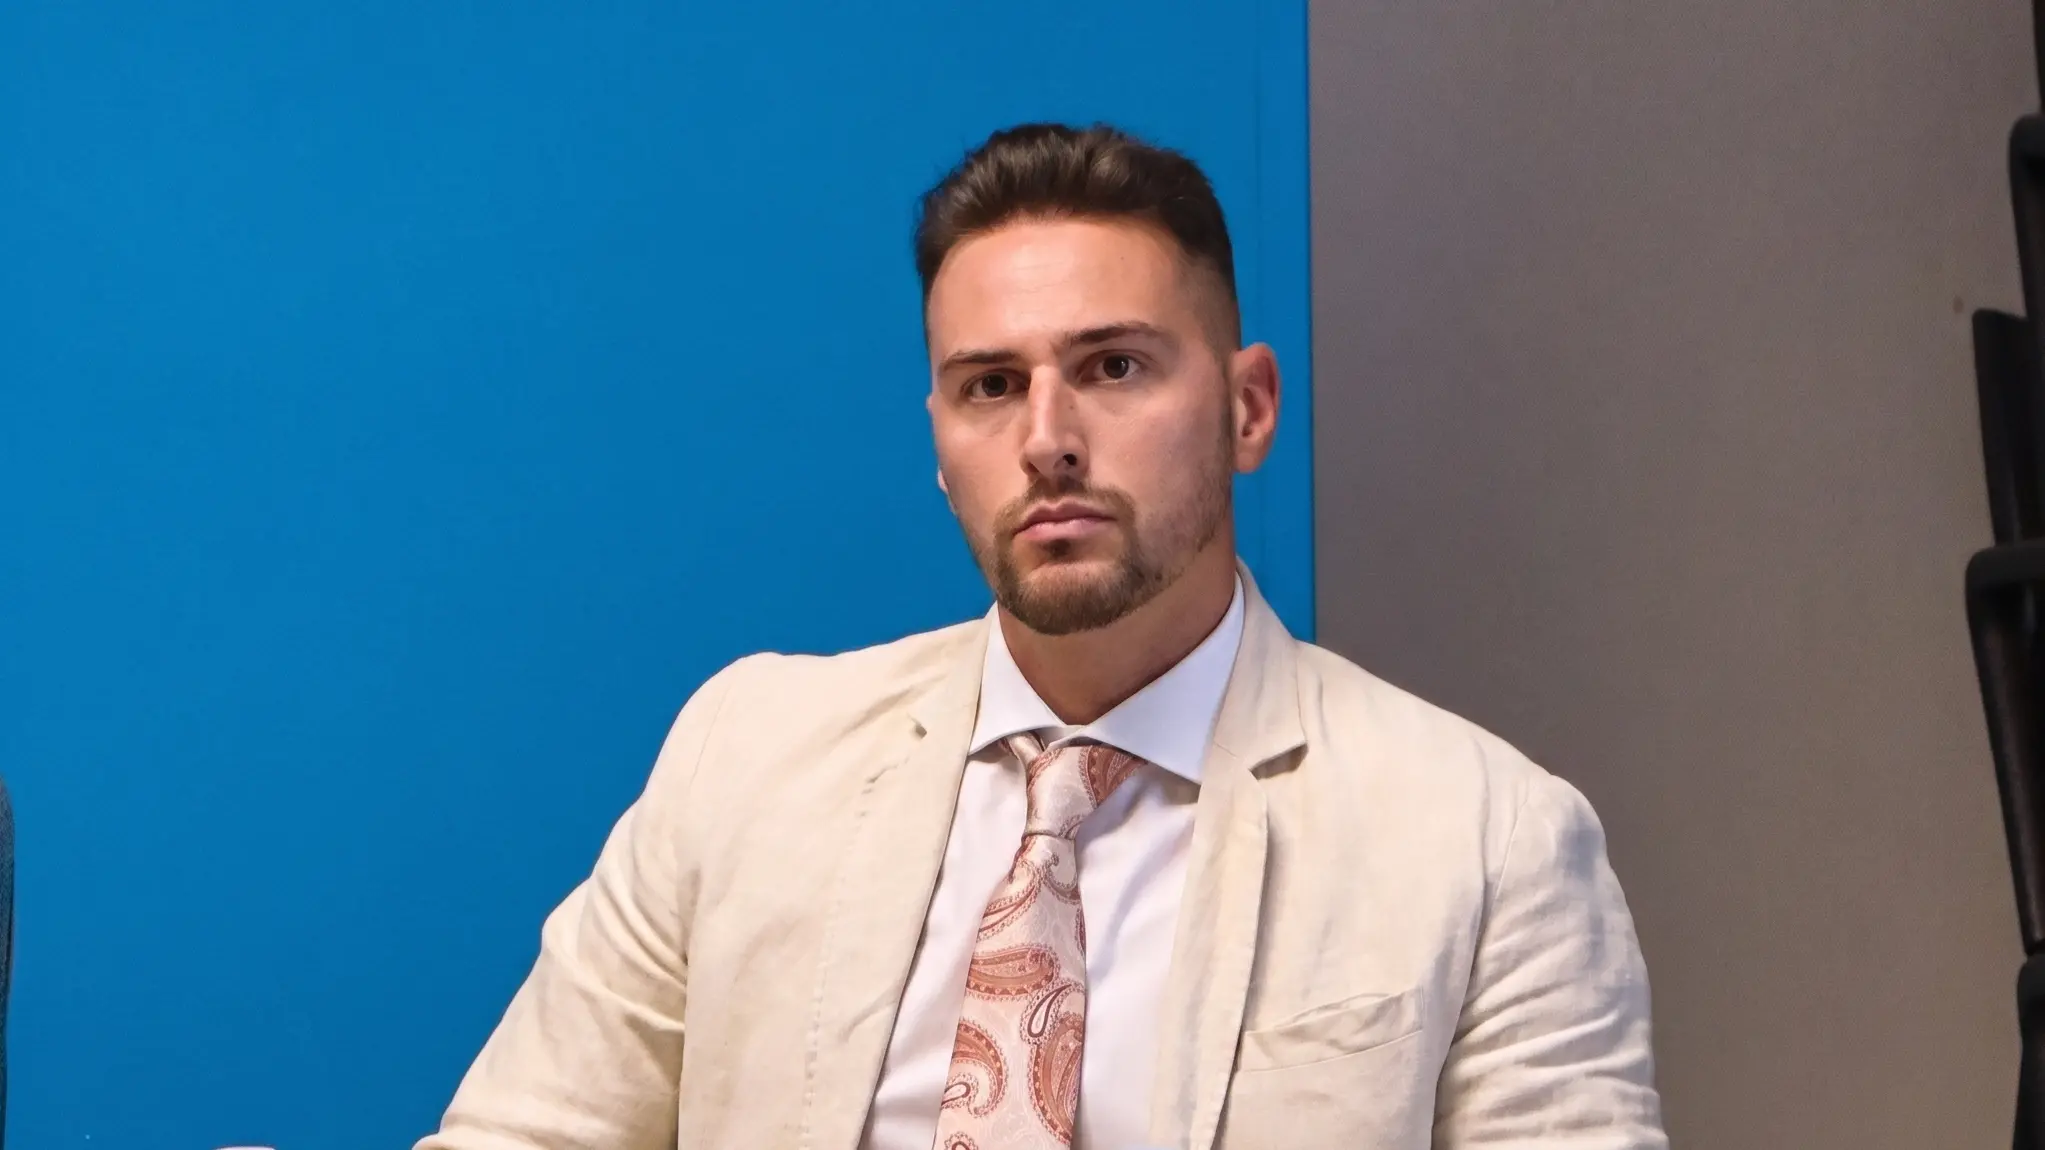
Andrea Simeri è un giovane e brillante ingegnere informatico, ricercatore in Intelligenza Artificiale e studente di Medicina all’Università della Calabria. Dopo la laurea magistrale in Ingegneria Informatica e il dottorato in AI, ha scelto di unire tecnologia e medicina, concentrando la sua ricerca soprattutto sull’urologia di precisione.
Studia l’impiego dell’intelligenza artificiale nell’analisi delle immagini diagnostiche, nella previsione degli esiti chirurgici e nella pianificazione degli interventi. Tra i suoi progetti più recenti c’è la “biopsia virtuale” delle masse renali, sviluppata attraverso TAC, ricostruzioni 3D e AI.
A settembre 2026, a Padova, il suo team ha ottenuto il Secondo Premio alla Best Video Competition di ERUS26, congresso europeo dedicato all’urologia robotica.

Simeri studia anche i limiti dell’intelligenza artificiale: da qui la sua provocazione, «l’AI è pigra. E il nostro lavoro è renderle la vita difficile». Una frase che racchiude la sua idea di ricerca: non fidarsi ciecamente degli algoritmi, ma metterli continuamente alla prova. Lo abbiamo intervistato.
Lei ha scritto che “l’AI è pigra” e che il nostro compito è renderle la vita difficile. Che cosa significa concretamente? E perché una scorciatoia trovata dall’algoritmo può diventare un problema per la medicina?
Dire che l’AI è “pigra” è naturalmente una provocazione. Un algoritmo non ragiona come una persona e non cerca necessariamente la spiegazione più corretta dal punto di vista clinico: cerca la regolarità statistica più semplice che gli consenta di ridurre l’errore. Se nei dati esiste una scorciatoia, il modello la utilizzerà. Può riconoscere l’ospedale da una combinazione di tecniche chirurgiche, identificare un’apparecchiatura radiologica da piccoli artefatti dell’immagine o associare un determinato protocollo clinico all’esito. La previsione può risultare corretta nel dataset di partenza, ma per una ragione sbagliata. In medicina questo è pericoloso perché quella scorciatoia potrebbe non esistere in un altro ospedale, in una popolazione differente o dopo un cambiamento dei protocolli. “Rendere la vita difficile” all’AI significa quindi costruire esperimenti nei quali le correlazioni facili e spurie non siano sufficienti: separare correttamente la fasi di addestramento (training) da quella di test, verificare le performance in contesti differenti e confrontare il modello con benchmark semplici per comprendere se e quanto é davvero efficace. Il nostro compito non è aiutare l’algoritmo a ottenere il numero migliore, ma costringerlo a imparare qualcosa che abbia realmente significato clinico. In fondo, gran parte dell’intelligenza artificiale moderna, e in particolare il machine learning, può essere interpretata come un’implementazione informatica del ragionamento induttivo: partire da una serie di osservazioni particolari per ricavare una regola che aspira ad avere validità generale. Il punto critico è proprio questo: una regola può descrivere molto bene le osservazioni disponibili senza essere realmente generale. Perciò non basta verificare che il modello abbia imparato, ma bisogna comprendere che cosa abbia imparato e fin dove quella conoscenza possa essere applicata.
Nel vostro studio sulla previsione della funzione renale dopo un intervento chirurgico, il modello sembrava funzionare molto bene, fino a quando avete cambiato il sistema di validazione. Che cosa avete scoperto e quanto è frequente questo rischio nella ricerca sull’intelligenza artificiale?
Il nostro modello per prevedere la funzione renale dopo una nefrectomia parziale mini-invasiva, eseguita con tecnica laparoscopica o robotica, funziona molto bene e mostra metriche di assoluto interesse clinico, che meritano certamente di essere approfondite. Quando, però, abbiamo provato a introdurre un’ulteriore variabile postoperatoria precoce, le performance sono diventate apparentemente non più soltanto ottime, ma eccezionali. Proprio per questo abbiamo deciso di analizzare più attentamente ciò che stava accadendo. Con una cross-validation casuale, nella quale pazienti provenienti dagli stessi centri erano presenti sia nel training sia nel test, il modello manteneva risultati estremamente promettenti. Quando gli abbiamo invece chiesto di effettuare predizioni su pazienti provenienti da un centro completamente escluso dall’addestramento, le performance si sono ridotte sensibilmente. Tornando ai dati abbiamo scoperto due aspetti. Innanzitutto, le combinazioni di tecniche chirurgiche erano così caratteristiche da rappresentare una sorta di impronta digitale dell’ospedale. Il centro non era esplicitamente indicato, ma il modello poteva riconoscerlo indirettamente. Inoltre, in alcuni centri determinate misurazioni di follow-up coincidevano con valori raccolti in un momento precedente. Il modello aveva quindi imparato a riconoscere il centro e ad applicare il comportamento specifico presente nei suoi dati. Questo non significa che la cross-validation casuale sia sbagliata: misura la capacità di predire nuovi pazienti appartenenti alla stessa popolazione multicentrica. L’esclusione di un intero centro risponde invece a una domanda differente: il modello funzionerà anche in un ospedale mai osservato? Il rischio è molto frequente e viene definito, a seconda dei casi, data leakage, shortcut learning o dataset shift. È uno dei motivi per cui una performance elevata non basta: bisogna sempre chiedersi che cosa il modello abbia realmente imparato e se ciò che ha imparato resterà valido nel contesto clinico reale.
C’è una questione fondamentale: se un algoritmo produce una risposta corretta, dobbiamo sapere anche perché ci è arrivato? Quanto è importante oggi rendere l’AI più interpretabile, soprattutto quando entra in una sala operatoria?
Non abbiamo necessariamente bisogno di ricostruire ogni singolo passaggio matematico, anzi non sarebbe praticabile proprio per definizione soprattutto quando parliamo di deep learning dove il numero di parametri è enorme, ma dobbiamo sapere su quali informazioni si basa il modello, quando è affidabile e soprattutto quando potrebbe sbagliare. In medicina una risposta corretta non è sufficiente se deriva da una scorciatoia instabile. Un modello potrebbe funzionare perché riconosce un artefatto dell’immagine, una macchina specifica o una modalità locale di raccolta dei dati. In quel caso l’apparente accuratezza scomparirebbe appena cambiasse il contesto. L’interpretabilità, però, non può ridursi a una figura colorata o a una lista di variabili importanti. Significa verificare la coerenza clinica delle predizioni, studiare gli errori, misurare l’incertezza, controllare le performance nei diversi sottogruppi e definire chiaramente la popolazione nella quale il modello può essere utilizzato. Questo diventa ancora più importante in sala operatoria, dove una decisione può avere conseguenze immediate. L’AI deve fornire un supporto comprensibile e verificabile, non un verdetto incontestabile. Al crescere del rischio clinico deve crescere anche il livello di evidenza richiesto.
A ERUS26 avete ricevuto il Secondo Premio per il progetto della “biopsia virtuale” delle masse renali. È possibile arrivare a conoscere la natura e il rischio di un tumore attraverso una TAC e l’intelligenza artificiale, riducendo in alcuni casi la necessità di una biopsia tradizionale.
Una TAC, una risonanza magnetica, un'ecografia contengono molte più informazioni di quelle immediatamente visibili all’occhio umano. Forma, densità, margini, distribuzione interna, modalità di assorbimento del contrasto e caratteristiche della texture descrivono il fenotipo radiologico della massa. L’intelligenza artificiale può integrare questi segnali e stimare, in termini probabilistici, la natura della lesione e alcuni elementi associati alla sua aggressività. È questo il concetto che chiamerei profilazione della lesione più che “biopsia virtuale”: ottenere dall’immagine informazioni che oggi richiedono procedure più invasive. È però importante evitare promesse eccessive. Non significa sostituire la biopsia tradizionale né affermare con certezza la natura di ogni tumore. L’obiettivo realistico è costruire uno strumento di supporto capace di identificare i pazienti nei quali una procedura invasiva potrebbe essere evitata e quelli nei quali rimane indispensabile. Per arrivare all’applicazione clinica servono validazioni multicentriche, protocolli radiologici armonizzati, confronto con l’esame istologico e studi prospettici. Il premio è un riconoscimento importante, ma soprattutto uno stimolo a trasformare un risultato di ricerca in uno strumento clinicamente affidabile.
Il vostro lavoro mette insieme Università della Calabria, Candiolo e Università di Torino. Quanto conta la collaborazione tra informatici, urologi, radiologi e oncologi per costruire un’intelligenza artificiale realmente utile alla medicina?
È essenziale. Nessuna di queste competenze, presa in modo isolato, è sufficiente. L’informatico può costruire un modello tecnicamente sofisticato, ma senza il contributo dei clinici rischia di rispondere perfettamente a una domanda irrilevante. L’urologo identifica il problema chirurgico e il bisogno del paziente; il radiologo conosce il significato e i limiti delle immagini; l’oncologo collega la previsione alle decisioni terapeutiche e alla storia della malattia. Chi si occupa di statistica e intelligenza artificiale deve trasformare queste domande in esperimenti rigorosi, controllando bias, leakage e generalizzabilità. La vera innovazione nasce proprio nel punto di incontro tra linguaggi differenti. Non basta mettere più specialisti nello stesso progetto: bisogna costruire una domanda comune, definire insieme gli endpoint e interpretare insieme gli errori. È anche per questo che ho scelto di non limitarmi a essere un ricercatore di intelligenza artificiale applicata alla medicina, ma di intraprendere il percorso per diventare medico. Il mio obiettivo è contribuire a colmare il divario tra competenze tecnologiche e cliniche e facilitare la comunicazione tra medici e data scientist: una comunicazione tutt’altro che scontata, perché queste figure spesso osservano lo stesso problema utilizzando linguaggi, priorità e strumenti differenti. Un’intelligenza artificiale realmente utile alla medicina non nasce soltanto nel dipartimento informatico o nel reparto. Nasce nel dialogo continuo tra entrambi e dalla presenza di persone capaci di fare da ponte tra questi mondi.
Lei ha detto che il futuro della medicina sarà sempre più esatto e tecnologico, ma che il suo cuore resterà umano. Qual è il ruolo che l’intelligenza artificiale non dovrebbe mai togliere al medico?
L’intelligenza artificiale può analizzare immagini, integrare migliaia di variabili, stimare rischi e ridurre attività ripetitive. Non dovrebbe però sostituire la responsabilità clinica, la relazione con il paziente e la capacità di attribuire significato a una decisione. Due pazienti con lo stesso rischio statistico possono avere paure e priorità completamente differenti. Decidere non significa soltanto scegliere l’opzione con la probabilità matematica migliore: significa comprendere la persona, spiegare l’incertezza e costruire insieme un percorso di cura. Il medico deve rimanere responsabile dell’interpretazione e della decisione finale. L’AI dovrebbe eliminare l'errore umano, liberargli tempo e risorse cognitive permettendogli di dedicarsi maggiormente alle attività nelle quali l’essere umano è insostituibile: ascoltare, contestualizzare, empatizzare, assumersi la responsabilità e prendersi cura. La tecnologia dovrebbe rendere la medicina più umana, non allontanarla dal paziente.
Lei ha scelto di sviluppare ricerca e innovazione in Calabria. È possibile costruire proprio qui un polo di eccellenza sull’intelligenza artificiale applicata alla medicina? E che cosa servirebbe, oggi, per fare il salto di qualità?
Sì, è possibile. L’eccellenza non dipende dalla geografia, ma dalla capacità di creare competenze, infrastrutture e continuità. La Calabria dispone di talenti, università e bisogni clinici reali che possono diventare il punto di partenza per una ricerca di grande valore. Per fare il salto di qualità servono però investimenti stabili, non iniziative isolate. Occorrono infrastrutture per la gestione sicura dei dati sanitari, registri clinici di qualità, capacità di calcolo, personale dedicato alla ricerca e percorsi professionali che permettano ai professionisti di tornare ma soprattutto di restare. Serve inoltre una rete strutturata tra università, ospedali, istituzioni e imprese, aperta alle collaborazioni nazionali e internazionali. Il vero capitale sono le persone. Un polo di eccellenza nasce quando medici, ingegneri, biologi, statistici e ricercatori possono lavorare insieme con obiettivi di lungo periodo. La Calabria non deve limitarsi a utilizzare tecnologie sviluppate altrove. Può contribuire a progettarle, validarle e renderle utili ai pazienti. Per riuscirci servono visione, organizzazione e il coraggio di investire con continuità. La strada è ancora lunga, ma è quello che nel mio piccolo sto tentando di fare.